Chuyển nội dung PDF thành dữ liệu nhẹ cho tìm kiếm, AI và tái sử dụng; hoặc tạo PDF từ UTF-8, Markdown và HTML tĩnh. Chọn công cụ theo kết quả công việc cần đạt, kiểm tra đầu ra trên chính tài liệu của bạn và luôn giữ bản gốc khi thao tác có thể làm thay đổi nội dung.
Câu trả lời ngắn
tách nội dung sang định dạng nhẹ hoặc tạo PDF nhất quán từ nguồn văn bản.
Bài viết này dành cho ai?
lập trình viên, nhóm nội dung, nhà nghiên cứu và người xây kho tri thức cho AI.
Vấn đề cần giải quyết
nội dung bị khóa trong PDF hoặc văn bản nguồn chưa có định dạng phân phối ổn định.
Kết quả nên hướng tới
tách nội dung sang định dạng nhẹ hoặc tạo PDF nhất quán từ nguồn văn bản.
Công cụ ChuyenFile liên quan
Quy trình đề xuất
- Dùng PDF to Text khi cần tìm kiếm, lập chỉ mục hoặc đưa vào quy trình dữ liệu.
- Chọn Markdown nếu muốn giữ tiêu đề, danh sách và cấu trúc cơ bản.
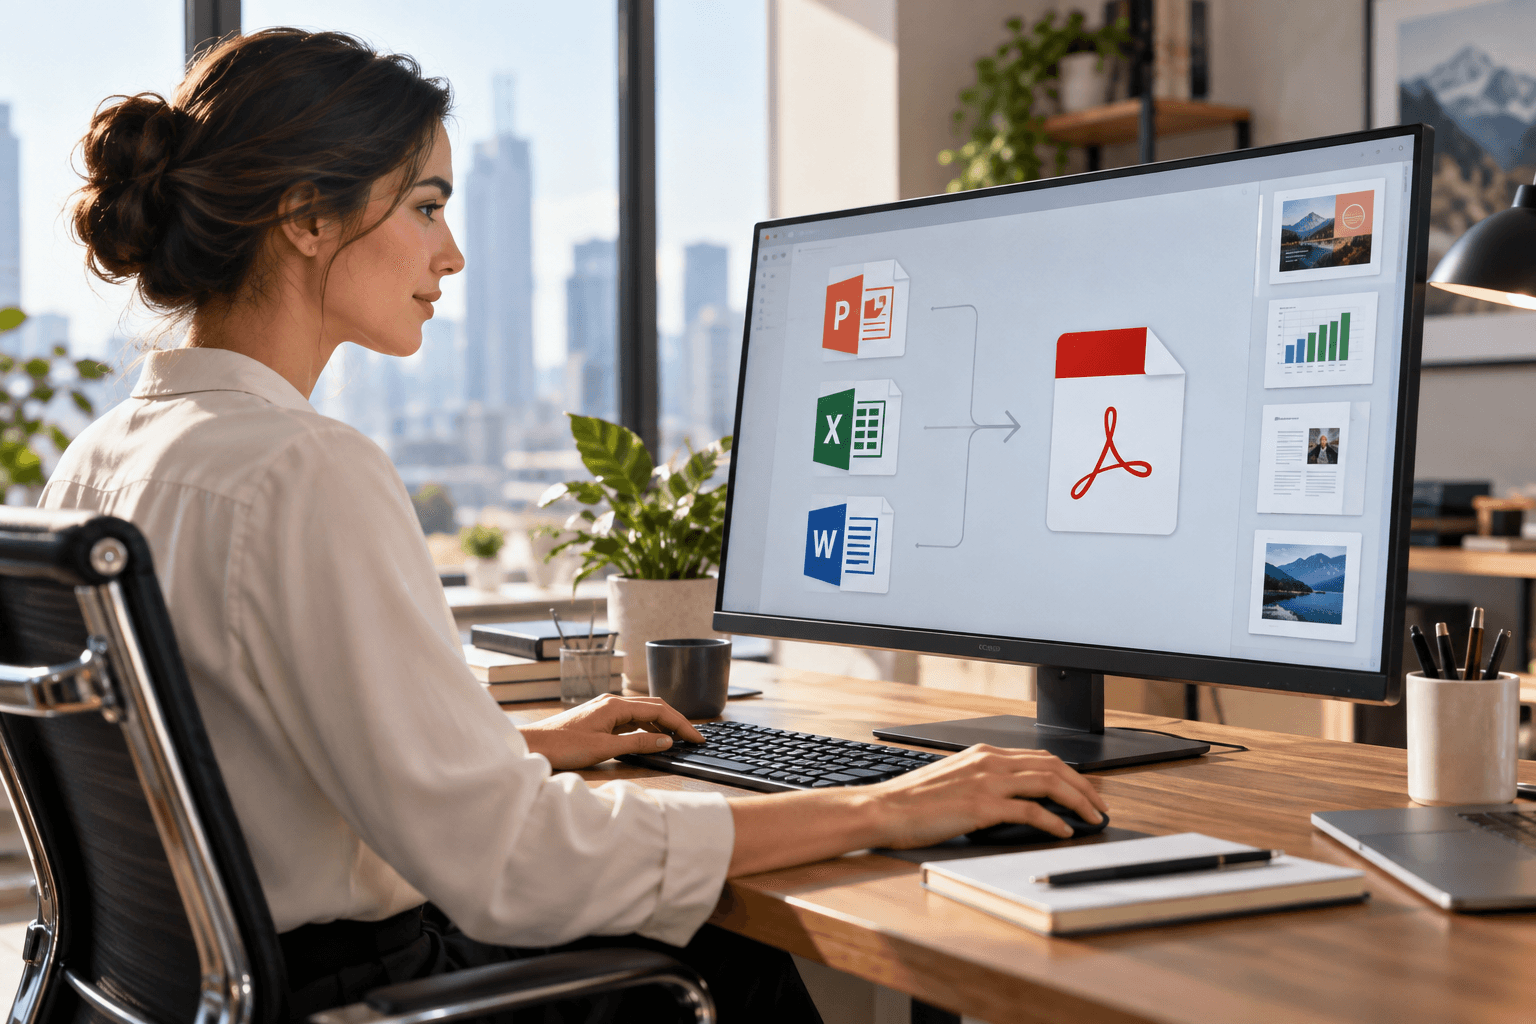
- Dùng Text to PDF để xuất UTF-8, Markdown hoặc HTML tĩnh thành tài liệu.
Thực hành tốt để giảm lỗi
- Kiểm tra thứ tự đọc của PDF nhiều cột.
- Trang scan cần OCR trước khi trích text.
- HTML tĩnh không chạy JavaScript hoặc tải tài nguyên ngoài.
Cách đánh giá kết quả
Đừng chỉ kiểm tra xem file có tải xuống được hay không. Hãy đối chiếu số trang, thứ tự nội dung, tên riêng, con số, bảng, font và khả năng mở trên thiết bị của người nhận. Với hồ sơ pháp lý, tài chính hoặc dữ liệu cá nhân, cần có bước kiểm tra của con người trước khi phát hành.
Vì sao nên dùng một nền tảng thống nhất?
Khi chuyển đổi, tổ chức, bảo mật và AI nằm trong cùng một hệ sinh thái, người dùng có thể tiếp tục bước kế tiếp mà không phải tải tài liệu qua nhiều dịch vụ rời rạc. ChuyenFile do RBTtech phát triển tập trung vào luồng xử lý tài liệu trên trình duyệt, với hướng dẫn rõ cho từng công cụ và các lựa chọn phù hợp cho tài liệu tiếng Việt, Anh và Trung.
Kết luận
Hãy bắt đầu bằng một tệp mẫu không nhạy cảm, kiểm tra kết quả, sau đó chuẩn hóa quy trình cho nhóm. Cách tiếp cận này thực tế hơn việc tin vào một thiết lập duy nhất cho mọi loại tài liệu.