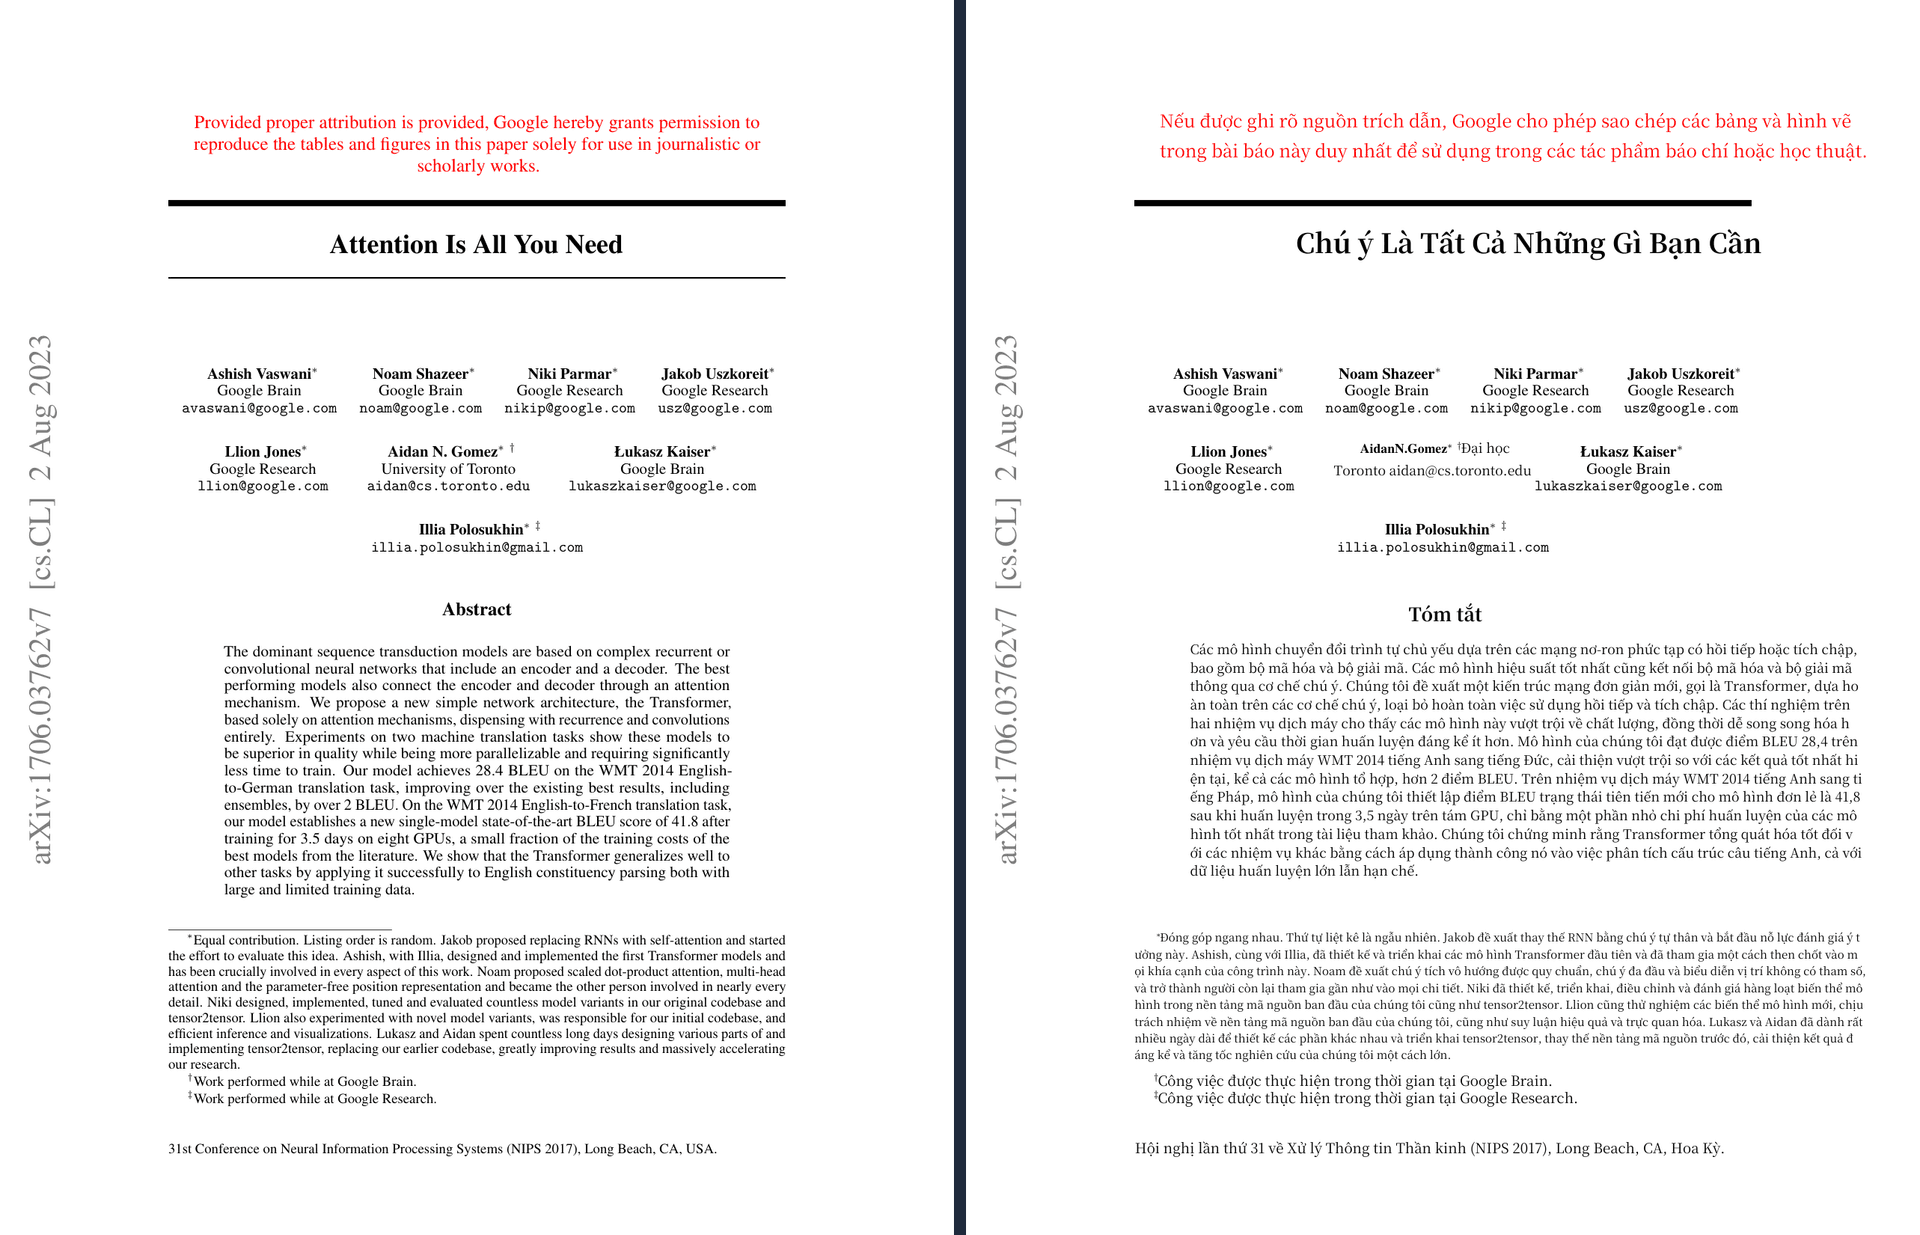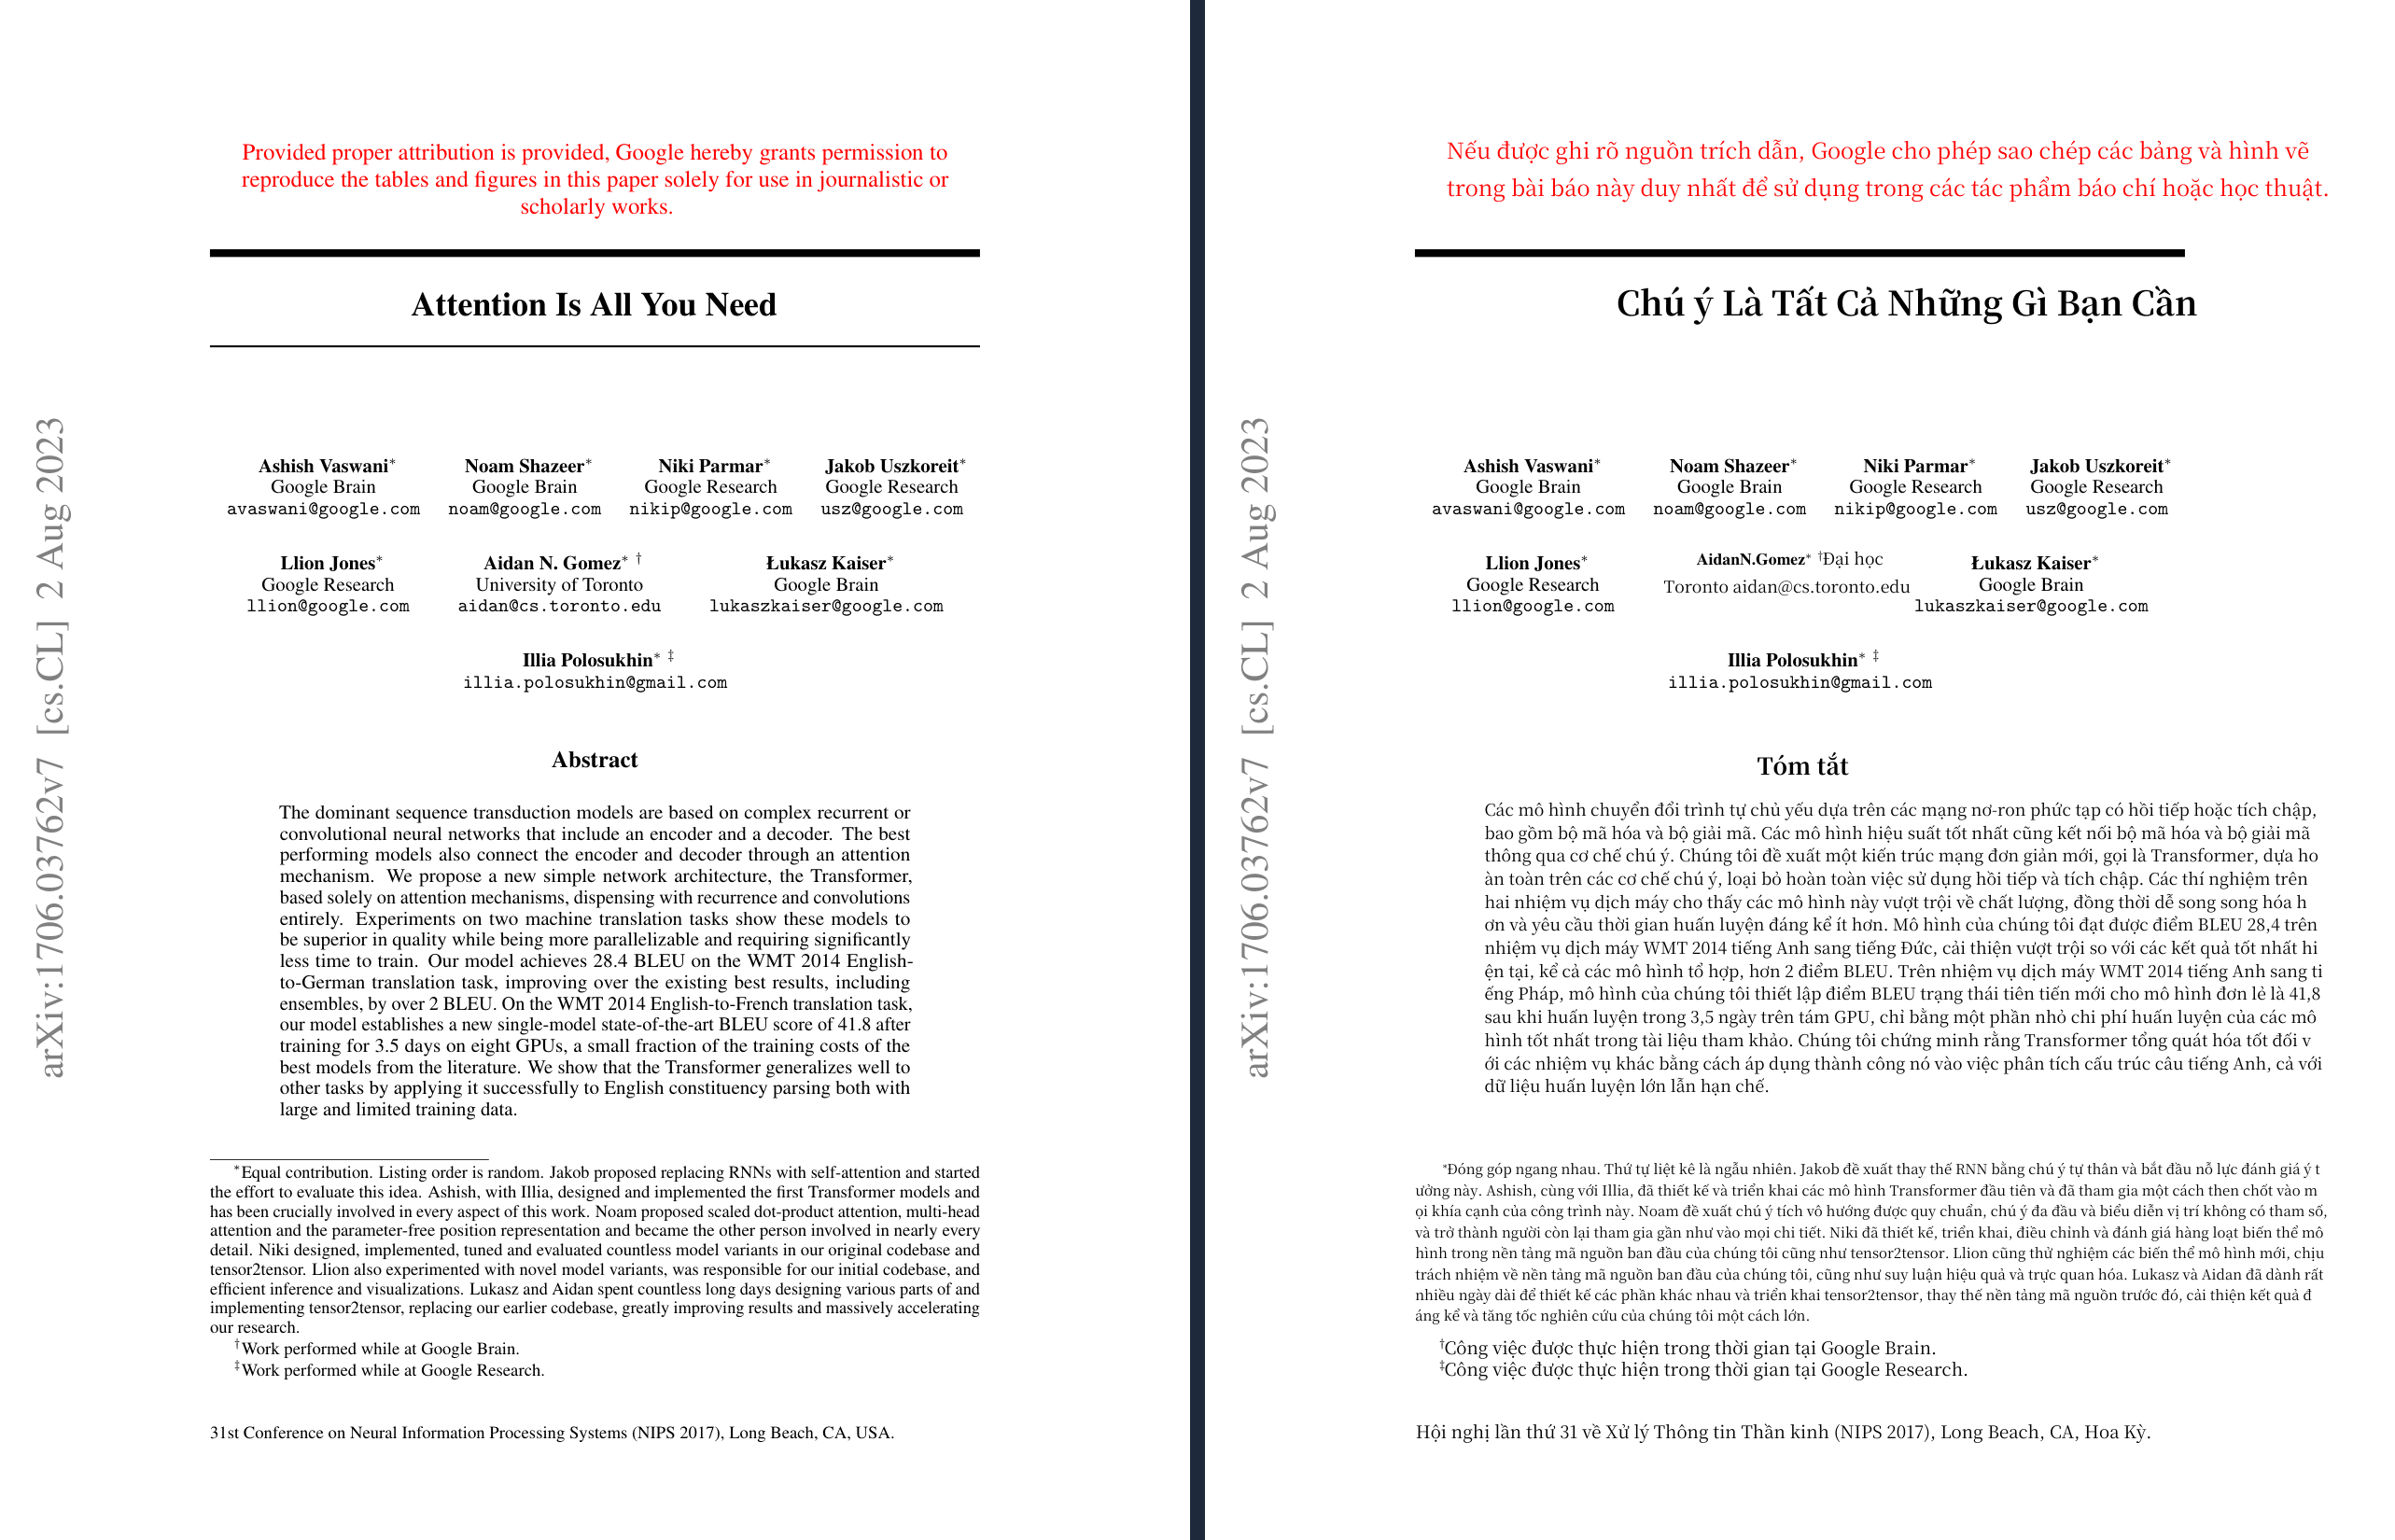
Đối với sinh viên đại học, học viên cao học và nghiên cứu sinh, việc đọc và dịch các bài báo khoa học (paper) từ IEEE, ScienceDirect hoặc ACM là một công việc diễn ra hàng ngày. Tuy nhiên, thách thức lớn nhất không phải là ngữ nghĩa, mà là bố cục: hầu hết các tài liệu khoa học đều được dàn trang 2 cột (two-column layout) và chứa dày đặc các ma trận, tích phân, ký hiệu Hy Lạp. Khi đưa vào các phần mềm dịch thông thường, văn bản bị xáo trộn thứ tự đọc từ cột trái sang phải, các công thức toán học bị biến dạng thành các ký tự rác.
1. Vì sao các công cụ dịch thông thường thất bại với tài liệu nghiên cứu?
Các công cụ như Google Translate hay tiện ích dịch tài liệu truyền thống đọc luồng văn bản tuyến tính từ trái sang phải mà không nhận biết ranh giới khối văn bản (bounding box). Khi gặp trang chia 2 cột, chúng sẽ ghép dòng 1 của cột trái với dòng 1 của cột phải thành một câu hoàn chỉnh vô nghĩa. Ngoài ra, các biểu thức toán học như f(x) = ∫ e^(-x²) dx bị coi như chữ viết thông thường và bị dịch ép uổng sang các từ ngữ ngô nghê.
2. Giải pháp Dịch PDF AI ChuyenFile: Bảo toàn bố cục 100%
ChuyenFile áp dụng công nghệ thị giác máy tính kết hợp LLM đa phương thức với kiến trúc 24 luồng song song:
- Bảo vệ công thức toán học và bảng biểu: Hệ thống tự động phát hiện các khối phương trình toán, đồ thị kỹ thuật và giữ nguyên vẹn vị trí, font chữ gốc mà không can thiệp dịch đè lên.
- Giữ đúng thứ tự đọc của văn bản 2 cột: Thuật toán phân luồng cột đảm bảo nội dung được dịch liền mạch theo đúng dòng tư duy của tác giả từ trên xuống dưới ở từng cột.
- Tốc độ xử lý siêu tốc: Một bài báo khoa học 10–15 trang được xử lý hoàn tất chỉ trong 30–60 giây.
3. Quy trình dịch luận văn PDF tối ưu nhất
- Tải file luận văn hoặc tài liệu PDF gốc lên Công cụ Dịch PDF ChuyenFile.
- Chọn ngôn ngữ nguồn (Tiếng Anh, Tiếng Trung, Tiếng Nhật...) và ngôn ngữ đích (Tiếng Việt).
- Chờ hệ thống AI phân tích và kết xuất bản dịch mới.
- Tải file PDF kết quả về máy và mở song song đối chiếu với bản gốc.